Quando si parla di ricerca in intelligenza artificiale, il pensiero corre quasi automaticamente a un gruppo ristretto di strumenti: Python per addestrare i modelli, i grandi cloud provider per l'infrastruttura, un pugno di framework dominanti per portare tutto in produzione. È un'immagine corretta, ma parziale. C'è una parte più silenziosa della ricerca in AI, altrettanto importante, che si svolge dentro ecosistemi open source costruiti su linguaggi come R, dove il rigore statistico, la riproducibilità e strumenti pensati collettivamente continuano a influenzare come i sistemi di intelligenza artificiale vengono progettati, valutati e, in ultima analisi, resi affidabili.
Le fondamenta statistiche non passano mai di moda
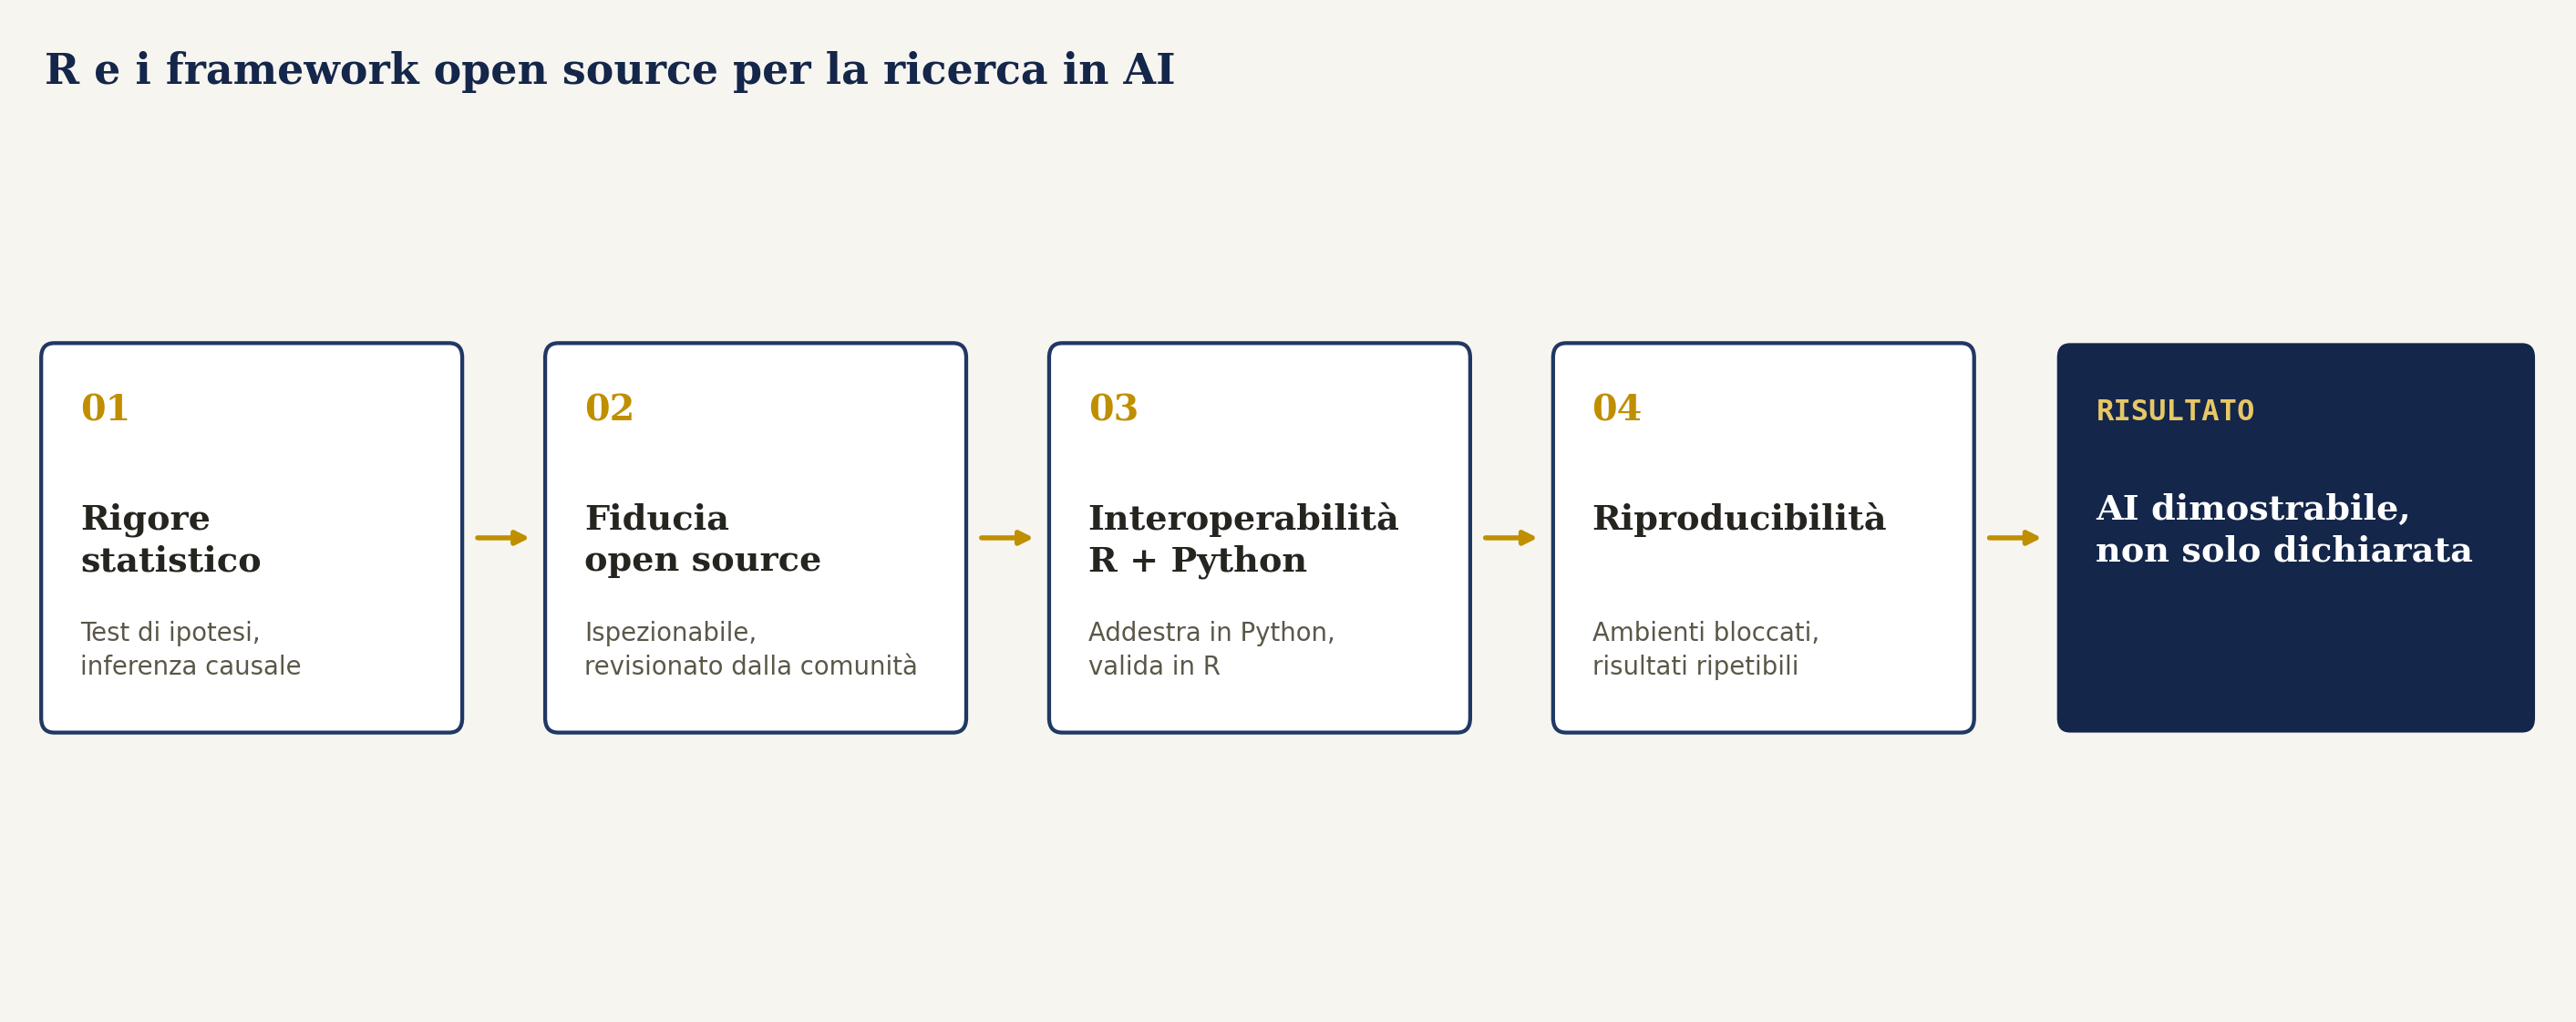
Si tende a raccontare la ricerca in AI come una disciplina prima di tutto ingegneristica, ed è vero per molti aspetti. Ma sotto gli strumenti e le pipeline, i sistemi che si stanno studiando restano modelli statistici. Capire l'incertezza, verificare le assunzioni, misurare i bias, interpretare perché un modello si comporta in un certo modo: sono domande statistiche prima ancora che software. È esattamente il terreno su cui R è nato.
E questo terreno conta sempre di più, non di meno, man mano che i sistemi di AI entrano in ambiti regolamentati e ad alto rischio. Un modello che in media funziona bene ma fallisce in modo imprevedibile su una parte degli utenti non è un risultato pronto per la produzione, per quanto sia stato costruito con cura il software intorno. Test di ipotesi, intervalli di confidenza, regressione robusta, inferenza causale: sono strumenti che l'ecosistema R ha affinato per decenni, e che oggi si applicano direttamente ai problemi di valutazione che la ricerca in AI tratta come priorità.
L'open source come garanzia di fiducia
Negli ultimi anni uno dei cambiamenti più rilevanti nella ricerca in AI è stato il passaggio da valutazioni chiuse a valutazioni aperte, non più come opzione ma come aspettativa di base. Una pipeline di valutazione proprietaria rende quasi impossibile, per chiunque non appartenga a quel laboratorio, verificare se un modello si comporta davvero come dichiara un paper. Gli strumenti open source risolvono questo problema alla radice: rendono la logica di valutazione ispezionabile, riproducibile, e migliorabile da una comunità intera, non da un singolo autore.
È proprio su questo terreno che la cultura open source di R pesa più di quanto la sua dimensione lascerebbe pensare. L'ecosistema CRAN, e la comunità che lo circonda, impone da decenni standard di documentazione, testing e revisione tra pari che molti ecosistemi AI più recenti stanno solo ora iniziando a raggiungere. Portare la stessa disciplina, risultati riproducibili, dipendenze versionate, metodologia trasparente, dentro gli strumenti di valutazione e ricerca in AI significa dare al settore un modo concreto per far verificare i propri risultati, invece di chiedere che vengano semplicemente creduti.
Il posto di R dentro una pipeline dominata da Python
R non ha bisogno di sostituire Python per restare rilevante nella ricerca in AI, e trattarli come due contendenti fraintende come lavorano davvero i team più efficaci. Python resta la scelta naturale per addestrare i modelli, per i framework di deep learning, per il deployment. R resta uno strumento eccezionale per l'analisi esplorativa dei dati, la validazione statistica, il lavoro diagnostico basato sulla visualizzazione, e per quel tipo di disegno sperimentale rigoroso che intercetta i problemi prima che arrivino a un paper o a un prodotto finito.
Gli strumenti di interoperabilità hanno reso questa convivenza più semplice che mai. Pacchetti che permettono a R e Python di scambiarsi dati e richiamare direttamente le rispettive funzioni fanno sì che un team di ricerca non debba più scegliere un linguaggio a scapito dell'altro. Si può addestrare un modello in Python e validarlo con rigore in R, trattando i due passaggi come parti ugualmente centrali della stessa pipeline, non come un compromesso tra velocità e precisione.
La riproducibilità come requisito, non come aspirazione
La ricerca in AI ha un problema di riproducibilità noto e tutt'altro che risolto. Modelli addestrati su suddivisioni dei dati leggermente diverse, valutati con metriche leggermente diverse, o eseguiti su versioni software leggermente diverse, possono restituire risultati difficili da confrontare o di cui fidarsi davvero. Non è un caso che i framework di valutazione siano diventati negli ultimi anni un tema centrale della ricerca applicata, e non più un dettaglio da sistemare alla fine.
L'ecosistema di pacchetti R ha sempre trattato la riproducibilità come un requisito di progettazione, non come un obiettivo auspicabile. Blocco delle versioni, snapshot degli ambienti, strumenti di programmazione letteraria che uniscono codice, risultati e narrazione in un unico documento verificabile: nella comunità R non sono idee nuove, sono prassi quotidiana. Portare lo stesso standard dentro le pipeline di ricerca in AI, in particolare su valutazione e benchmarking, dà una base molto più solida per affermare che un risultato pubblicato è reale e ripetibile, non un caso isolato legato a una singola esecuzione.
La direzione da qui in avanti
La ricerca in AI sta entrando in una fase in cui la domanda cambia: non più solo riusciamo a costruire un modello capace, ma riusciamo a dimostrare che si comporta come dichiariamo, in modo sicuro e coerente, nelle condizioni che incontrerà davvero. È una domanda prima di tutto statistica e metodologica, non solo ingegneristica. I framework open source che portano avanti decenni di rigore statistico, e comunità come quella costruita intorno a R, hanno un ruolo concreto da giocare in questa risposta.
Risorse per approfondire
- tidymodels/tidymodelstidymodels — un framework unificato per la modellazione e la validazione statistica in R
- mlr-org/mlr3mlr3 — un framework moderno di machine learning in R con benchmarking rigoroso integrato
- rstudio/reticulatereticulate — permette a R e Python di richiamarsi a vicenda nella stessa pipeline
- ropensci/targetstargets — un toolkit per pipeline riproducibili che traccia esattamente cosa ha prodotto ogni risultato
- rstudio/renvrenv — gestione degli ambienti a livello di progetto, per rieseguire i risultati con le stesse dipendenze
- responsibleai/ASSERTASSERT — un framework open source di valutazione per sistemi di AI, guidato dalle specifiche
Lavori su valutazione o strumenti di ricerca in AI?
Mi piacerebbe sapere come il vostro team affronta riproducibilità e valutazione aperta.
Scrivi a info@italai.ai